-
 Brody
- 2026/06/10
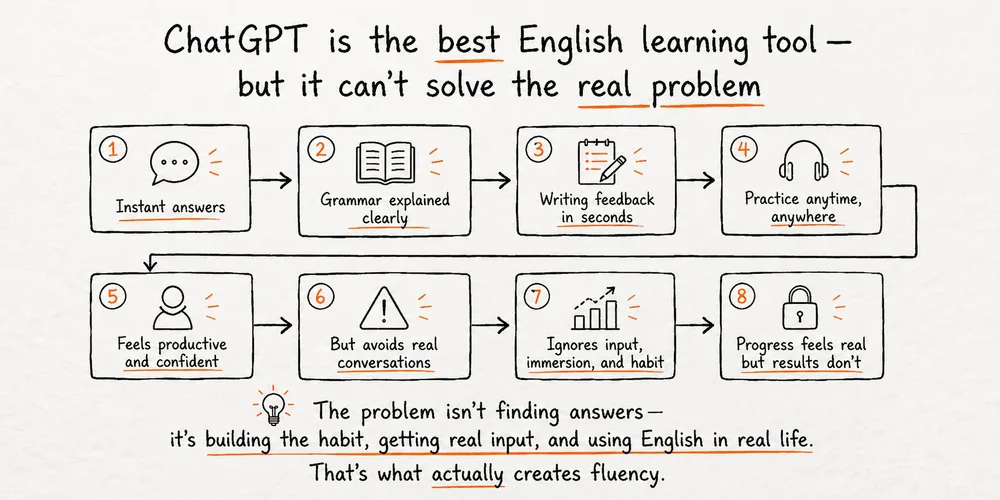
ChatGPT 是最好的英语学习工具——但它解决不了真正的问题
所有语言学习者的梦想,是拥有一个每周七天、每天二十四小时免费陪你练习的老师。现在这个梦想真的实现了——但学外语的人反而越来越少。前几天刷到一个英国英语老师 Christian 做的 YouTube 视频,标题是《用 ChatGPT 学英语》。我以为又是一期工具推荐,没想到看完之后,他根本不是在推销 ChatGPT,而是在给所有语言学习者泼一盆冷水。 这盆水浇得很准。 梦想成真了,然后呢? ChatGPT 这类大语言模型的出现,对语言学习者来说是真正的革命:请不起老师?问题解决了。 没有英语语境,没有人可以对话?问题解决了。 想要一个单词的十个例句,还要带发音?问题解决了。 想模拟电话面试、工作面试?问题解决了。Christian 在视频里真的演示了这个场景:他输入「我下周有一个工作面试,想练习英语」,ChatGPT 立刻接手,问他想重点练哪些方向,然后开始角色扮演。反应速度、覆盖广度、耐心程度,完胜任何一个真人外教。 按照正常逻辑,接下来的故事应该是:全球流利说外语的人大爆发,语言学习迎来黄金时代。 但现实完全相反。 越来越少的人在学外语 美国的数据最典型:过去五年,学外语的人数下降了 17%。这还只是英语母语者——他们确实有理由偷懒,因为英语本身就是通行证。 但问题是,即便是你——正在学英语的人——大概率也没有把 ChatGPT 变成每日练习的对话搭档。 Christian 说他是一名真正在课堂里工作的老师,几乎每天都和真实的学生打交道。他从没见过这么多人,对一场「革命」如此冷漠。 为什么? 这不是第一次了 答案其实很老:语言学习从来不是资源问题,而是人的问题。 他列了一张清单,每一条都让我觉得似曾相识—— 录音机时代:「我现在随时可以听真实对话了!英语学习从此又快又简单!」 互联网时代:「我可以找到无限内容和对话伙伴了!英语学习从此又快又简单!」 App 时代:「我上班坐地铁的五分钟就能学语法和词汇!英语学习从此又快又简单!」 AI 时代:「AI 将让英语学习又快又简单!」 每一次,都有同一句口号。每一次,都有同一个结局。 人们尝试一下,发现不是魔法,然后去找下一个「又快又简单」的东西。 战俘营里的英语课 这个道理,Christian 用了一个让我印象深刻的故事来说明。 1980 年,两伊战争爆发,持续了整整八年。战争中,数千名士兵被俘,关押在条件极为恶劣的战俘营里。那种地方,是为惩罚而设计的,是你能想到的学习语言最糟糕的环境。 但就是在那里,一些战俘开始学英语。 动机各不相同:有人是为了打发漫长的无聊和抑郁;有人觉得「时间是黄金」,不想浪费被俘的每一天;还有人是为了将来用英语改变命运。 他们没有书,没有铅笔,没有纸——这些东西都被明令禁止。会英语的战俘悄悄教其他人,课程在秘密中进行,因为守卫不允许任何形式的教育活动。 当外界没有任何资源的时候,他们在院子里捡起树枝,蹲下来,在泥土上写单词和句子。 结果如何?其中一些人,后来流利到可以在舞台上表演英语戏剧。 那些在战俘营里、用树枝在泥土上练英语的人,比大多数拥有所有工具和资源的现代学习者,学得更好。 这就是答案。 学习是买不到的东西 Christian 说了一句话,我觉得值得原文引用:「没有任何技术、系统或方法,能让语言学习变得快速或容易。学一门语言,可能是你成年后做过的最难的事。无论用什么方法,当你剥离掉技术、内容和老师,永远剩下同一件事:学习。这不是任何人或机器能替你做的,你也买不到它。你必须自己去做,你必须去赢得它。」我们点开那些「用 AI 学英语」的视频,内心深处都藏着一个小小的期待:也许这次,真的有捷径。 没有。 那 AI 究竟有没有用? 有,非常有用——但不是作为魔法,而是作为工具。 工具的价值,完全取决于使用它的人的心态。 一把好锤子,放在一个不想盖房子的人手里,毫无意义。放在一个每天坚持动工的人手里,它就是改变速度的利器。 ChatGPT 是有史以来最好的语言学习工具,没有之一。但它解决的是「有没有资源」的问题,不解决「想不想学」的问题。 如果你真的想学好英语,现在的条件比任何时代都要好。没有钱请老师,有 AI;没有人陪你练口语,有 AI;不懂某个表达,有 AI;想模拟面试,有 AI。 如果你不想学,那这一切都只是手机里又一个打开三天就被遗忘的 App。 时间才是最宝贵的资源 视频最后,Christian 把话题拉回了那些战俘。他们在最恶劣的条件下拼命学英语,是因为他们明白一件事: 时间是我们最宝贵的资源。 不是工具,不是方法,不是 App,不是 AI。 是时间。 你现在手里有全世界最好的语言学习工具,免费,随时可用。唯一的问题是,你打算从什么时候开始认真用它?这篇文章的灵感来自 Canguro English 的 YouTube 视频《Get fluent with AI - Use ChatGPT to learn and practice English》。Christian 是一位英国英语老师,他的频道专注于帮助非母语者真正掌握英语沟通能力,而不只是学语法。
- Brody
- 2026/06/06
当每个人都能造应用:AI 时代,分发是新的代码
一张图,说透 2026 年 AI 创业的真相 前几天在 X 上看到一张图(来自 FT,数据来源:Demirer et al, 2026),配着 @levelsio 的推文一起看,瞬间觉得很多事情串起来了。 先上图:这张图有三个数据系列,全部以 2024 年均值为基准 100:深蓝线(App 发布量):Agentic AI 时代后垂直拉升,2026 年已飙到 180——相当于 2024 年均值的 1.8 倍。 浅蓝线(有实质用户量的 App):纹丝不动,紧贴 100 基准线,整个 2025-2026 年毫无增长。 中蓝线(App 评论量):不升反降,跌到约 75,说明不仅新用户没增加,老用户的活跃度和满意度也在下滑。翻译过来就是一句话:能造船的人多了 80%,但港口的位置一个都没多。levelsio 说了什么 Pieter Levels(@levelsio)是独立开发者的标志性人物,一个人做了 NomadList、RemoteOK、PhotoAI、InteriorAI 等一系列产品,年营收 300 万美元以上,没有团队、没有融资。 他在转发这张图时写了这样一段话(大意):我认为挑战在于现在每个人都可以构建应用,但是:几乎没有人拥有分发渠道(比如受众) 有钱支付分发费用(广告或用户生成内容) 拥有免费获得分发的创意天才(传统上称为游击营销)这三句话,说得非常准。 他用三个条件定义了 AI 时代真正稀缺的东西——不是构建能力,是分发能力。为什么「能做出来」已经不够了 第一,信噪比正在崩溃 这张图最令人警觉的不是 App 发布量涨了多少,而是评论量在下降。 当一个市场里每个月涌入的产品是以前的两倍,用户的注意力并没有同步扩张。平台的通知栏、推荐位、搜索结果页——这些「发现机制」的承载能力是固定的。分蛋糕的人多了,每块蛋糕自然更小。 更糟糕的是,当大量低质量 AI 生成应用涌入商店,用户的信任度下降,整体转化率随之降低。这就是评论量下跌的深层原因:不是用户变少了,是用户变得更谨慎了。 第二,「受众」正在变成最强的护城河 levelsio 说的第一条——「几乎没有人拥有分发渠道(受众)」——是他自己成功的注脚。 他能在一天之内让一个新产品的启动页获得几万次访问,不是因为他懂增长黑客,而是因为他在 Twitter 上积累了百万级的关注者。他自己的账号就是他的营销部门。 AI 工具让构建成本趋近于零之后,你手上的读者关系反而变得更值钱了,不是更不值钱。因为产品可以 AI 生成,但信任不能。 第三,广告竞价正在杀死没有收入的初创产品 第二条,「有钱支付分发费用」——这听起来很世俗,但这就是现实。 Meta、Google、TikTok 的广告系统是为有收入的企业优化的。如果你是一个没有收入、没有融资的独立开发者,你根本竞不过那些有 ARR 的 SaaS 产品。他们可以负担更高的 CAC(客户获取成本),因为你没有收入来覆盖这个成本。 这意味着:没有收入的分发,必须靠创意或已有受众。这就是 levelsio 说的第三条——「创意天才(游击营销)」。 第四,平台是唯一的赢家 这张图对独立开发者是警示,对平台来说是机会。 苹果、微信、TikTok——谁控制着用户的注意力入口,谁就坐拥一切。当供给侧无限扩张、需求侧不变,平台的议价能力反而会提高。 这对独立开发者的启示是:选择平台比选择技术栈更重要。在微信生态里做一个小程序,可能比在 App Store 里发布一个原生应用更容易获得初始用户——因为微信的社交分发机制对小产品更友好。levelsio 自己就是最好的证明 levelsio 说这番话的时候,他不是在维护自己的优势——他是在用亲身经历论证自己的观点。 十年前,当他还是一个籍籍无名的数字游民,在 Twitter 上分享 NomadList 的构建过程时,没有人觉得「受众」是护城河。Build in Public 在那个年代是一种个人品牌建设,没有人把它当成一种战略。 但十年后回头看,他无意中做对了 AI 时代最重要的一件事:在供给过剩之前,提前占住了分发入口。他的受众 —— Twitter 百万粉丝,每条推文都是免费分发渠道 —— 是十年公开构建的自然沉淀,不是 AI 赋予的优势 他的收入 —— PhotoAI 等产品有稳定现金流,可以负担付费投放 —— 同样是积累的结果,不是一夜之间靠 AI 工具做出来的 他的创意营销 —— Build in Public 本身就是他的独特分发方式 —— 这件事 AI 再强也替代不了所以他的三个判断,不是站在高处说风凉话,而是坦诚地告诉你:我能走到今天,靠的就是这三样。而这三样,AI 帮不了你。这张图没告诉你的事 FT 的这张图只覆盖了「应用发布量」和「用户活跃度」,但有几个维度它没有展现: 第一,收入集中度。 发布量涨了 80%,但收入可能集中在顶部 1% 的产品里。如果真是这样,局势比图表看起来更严峻。 第二,企业级市场 vs 消费者市场。 这张图应该是消费者应用的数据。企业级 AI 工具(B2B)的分发逻辑完全不同——口碑、销售团队、集成生态才是关键,而不是 App Store 榜单。 第三,地理差异。 中美两个市场的分发逻辑截然不同。在美国,Twitter/X、Product Hunt、Reddit 是独立开发者的主战场;在中国,微信公众号、小红书、抖音才是。这张图如果只看美国数据,对中国的借鉴意义需要打折。对你来说,这意味着什么 如果你正在经营一个内容品牌(比如「AI知识迁移」),或者正在考虑做一个 AI 产品,这张图和 levelsio 的话给你以下几个行动点: 1. 把读者关系当成资产来管理,而不是流量。 粉丝数是一个虚荣指标,但「有多少人会点开你的每一篇文章」才是真正的护城河。levelsio 的三条护城河里,第一条就是最难被复制的。 2. 做产品之前,先想清楚分发。 以前的产品逻辑是:做一个好产品 → 用户会来。现在的逻辑应该是:想清楚怎么让用户知道 → 再做产品。顺序反了。 3. 善用平台的分发机制,而不是对抗它。 微信的「看一看」、小红书的算法推荐、抖音的同城——这些机制对小而美的产品是有利的,因为它们的推荐逻辑是「内容质量」而不是「广告预算」。 4. 把「Build in Public」当成分发策略,而不只是记录。 levelsio 的成功不是因为他产品做得最好,而是因为他最会让别人想看他的产品。这个过程本身就是营销。一句话总结 AI 时代的竞争,已经从「谁能做出来」转移到「谁能让人看到」。 构建是新时代的识字率——重要,但不再是稀缺能力。 分发才是新时代的代码。数据来源:Demirer et al, 2026,经由 Financial Times 可视化。推文来源:@levelsio(Pieter Levels),2026 年 6 月。
- Brody
- 2026/05/25
Hermes Agent vs OpenClaw:2026 年两个最火开源 AI Agent 的终极对比
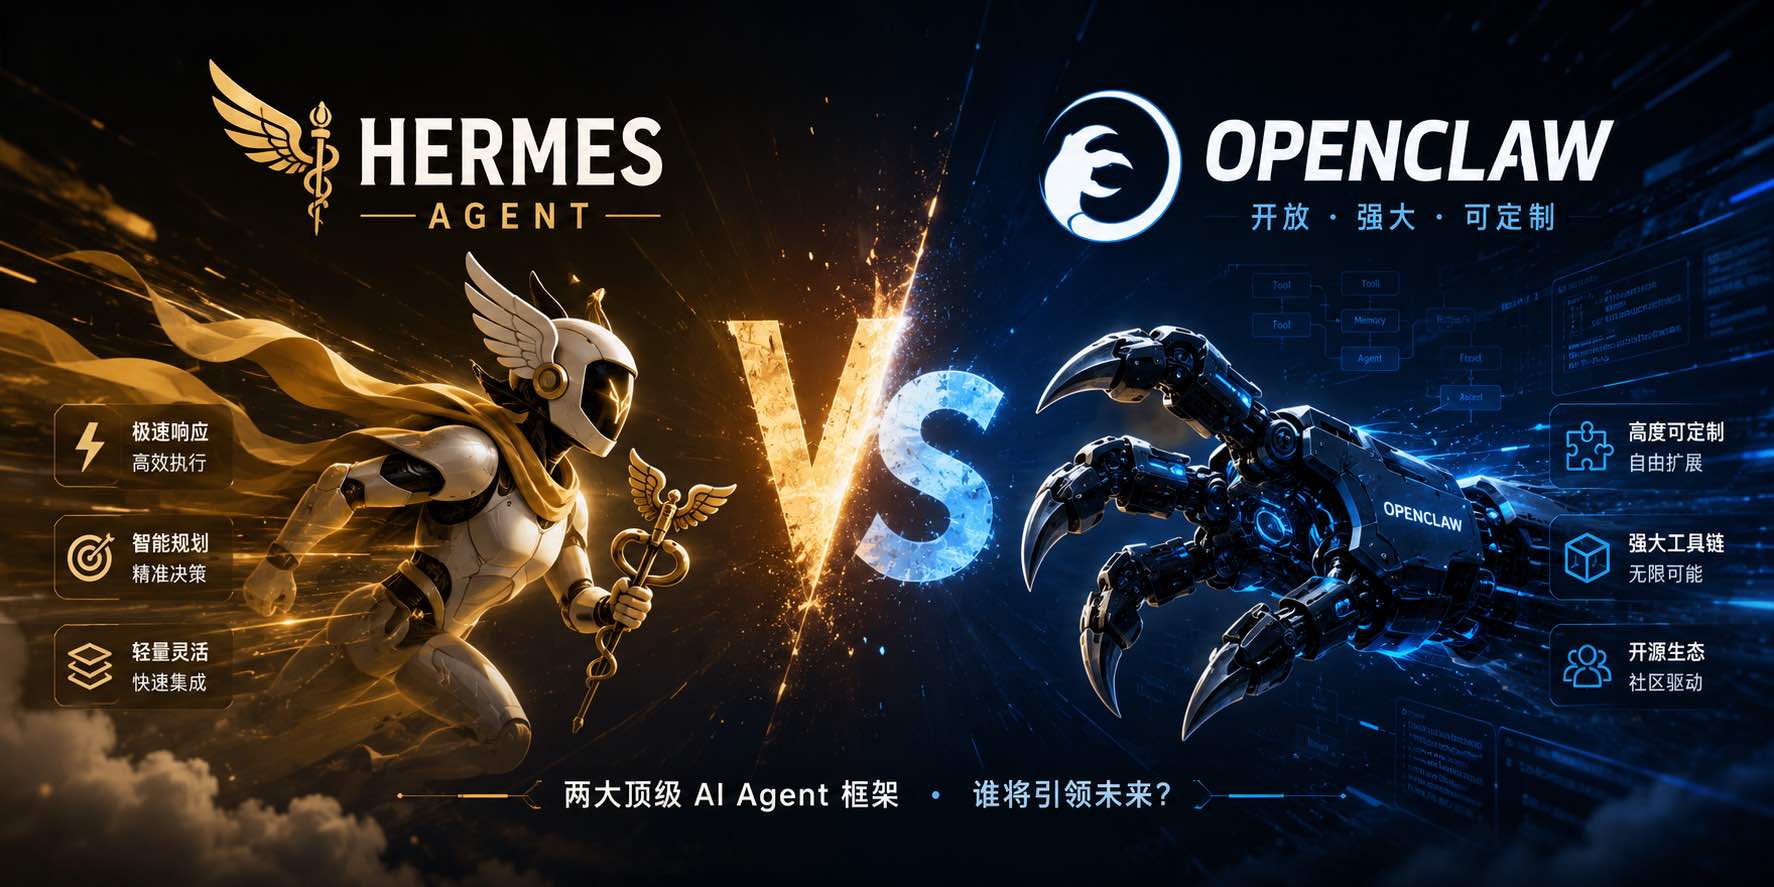
2026 年的开源 AI Agent 圈子,有两个项目你必须知道。 一个是 OpenClaw——2026 年 3 月超越 React 成为 GitHub 最高星标项目,目前 350k+ Stars,从一个个人副项目变成了现象级开源基础设施。 另一个是 Hermes Agent——Nous Research 出品,167k Stars,自称「唯一内置学习循环的 Agent」,核心卖点是越用越聪明。 如果你正在犹豫该用哪个(或者两个都想试试),这篇文章帮你把核心差异讲清楚。一句话定位 它们不是竞品,而是两条完全不同的路线:OpenClaw Hermes Agent一句话 让你定义规则,让 AI 执行 让 AI 自己学会做事代表路线 广度连接——接入最多的平台 深度进化——越用越懂你核心角色 执行者(Doer) 学习者(Learner)比喻 万能遥控器 会成长的徒弟五大维度深度对比 1. 架构与安全:CVE 教会了我们什么? 这是两个项目最根本的设计分歧。 OpenClaw 采用单进程架构——工具、集成、平台适配器全部运行在同一个地址空间。这种设计带来的好处是启动快、部署简单、资源占用低。但代价也在 2026 年 2 月暴露了:CVE-2026-25253:未认证的远程代码执行(RCE),CVSS 评分 8.8(高危),数万个未打补丁的实例被入侵。之后 OpenClaw 引入了 AgentWard(eBPF 探针监控)、SkillFortify(技能形式化验证)、Raypher(硬件身份认证)等安全组件,但本质上是在修补一个默认不隔离的架构。 Hermes Agent 从第一天起就是分层隔离架构: 平台适配器 → 网关进程 → Agent 运行时(受控接口)→ 工具执行(沙盒)平台网关无法直接访问 Agent 运行时,工具执行默认在沙盒内。截至 2026 年 5 月,Hermes Agent 没有已知的 CVE。💡 安全总结:OpenClaw 靠补丁堆砌安全,Hermes Agent 靠架构从源头限制爆炸半径。2. 记忆系统:谁记得更牢? 记忆系统是 AI Agent 的「大脑」。 OpenClaw 的记忆以 Markdown 文件为基础载体(SOUL.md、AGENTS.md 等),通过 Dinobase 提供生产级持久化存储。高级记忆功能(向量检索、知识图谱)需要额外安装插件。整体来说,手动可控,但需要深度定制。 Hermes Agent 的记忆是架构级原生设计:会话历史存储在 SQLite,支持 FTS5 全文检索 每次对话前自动加载相关记忆和技能 内置用户建模系统(集成 Honcho),持续积累你的沟通风格和偏好 零人工维护,全自动沉淀💡 记忆总结:Hermes 是懒人友好型——你什么都不用做,它自己记;OpenClaw 是控制狂友好型——你想让它记什么,它就记什么。3. 技能机制:最核心的差异 这是两者最本质的区别。 OpenClaw 的技能是人工编写 + 社区下载的。你需要去 ClawHub 技能市场搜索、安装、管理插件。生态成熟,技能数量丰富,但每次执行相同任务,Agent 都需要重新规划。 Hermes Agent 的技能是自动生成 + 自我进化的: 解决任务 → 记录技能文档 → 下次遇到类似任务 → 直接调用缓存技能 → 跳过规划阶段完成一个复杂任务后,Agent 会自动调用 skill_manage 工具生成一份标准技能文档,记录解决方法、遇到的陷阱、边界情况。使用过程中发现问题,还会通过 patch 动作精准优化。 Nous Research 内部基准测试显示,经过数周技能积累后,研究任务完成速度提升约 40%。💡 技能总结:OpenClaw 是「用现成技能」,Hermes 是「自己造技能」。短期 OpenClaw 更快(生态成熟),长期 Hermes 的复利效应更明显。4. 平台覆盖:25+ vs 7 这是 OpenClaw 的绝对主场。 OpenClaw 覆盖 25+ 消息平台:WhatsApp、Telegram、Slack、Discord、Signal、Email、iMessage、Microsoft Teams、Google Chat、Matrix、飞书、微信、LINE、IRC、Twitch……而且所有渠道共享同一个 Agent 和本地记忆。 Hermes Agent 目前支持 7 个平台:Telegram、Discord、Slack、WhatsApp、Signal、Email、CLI。能力 OpenClaw Hermes Agent消息平台 25+ 7语音模式 支持 不支持伴侣 App macOS + iOS + Android 无浏览器控制 支持 通过 MCPiMessage 独占 不支持💡 覆盖总结:如果你需要接入微信、飞书、iMessage 等平台,OpenClaw 目前没有对手。5. 成本与部署 两者的软件本身都免费开源。 主要成本在 LLM API 调用。如果你搭配 Ollama + 本地开源模型,两者都可以实现零 API 成本。维度 OpenClaw Hermes Agent安装 npm install -g openclaw 一键脚本(curl | bash)配置复杂度 简单上手,深度配置需学习 稍复杂,但后续自进化降低长期成本运行环境 Node.js(轻量) Python(稍重)Serverless 支持 无 Modal / Daytona(空闲时近乎零成本)💡 成本总结:两者都可以用最低 5$/月的 VPS 跑起来。Hermes 的 Serverless 后端是一个额外优势——不干活时不花钱。综合评分对比维度 OpenClaw Hermes Agent 胜出渠道覆盖 25+ 平台 7 平台 OpenClaw设备集成 语音/App/设备控制 CLI 为主 OpenClaw安全架构 补丁堆砌 分层隔离,零 CVE Hermes自我进化 不支持 闭环学习,+40% 效率 Hermes跨会话记忆 插件依赖,手动维护 FTS5 原生,全自动 Hermes技能生态 成熟丰富,即装即用 自动生成,复利增长 平手数据主权 本地优先,完全可控 未特别强调 OpenClaw安装便捷 一行 npm 命令 一键脚本 平手你该怎么选? 选 OpenClaw 的场景你是个人用户,需要接入微信、飞书、iMessage 等平台 你需要语音交互或 macOS/iOS/Android 伴侣 App 你重视数据主权,所有数据留在本地 你已经有成熟的技能工作流,不需要 Agent 自己学选 Hermes Agent 的场景你希望 Agent 越用越聪明,自动积累经验 你处理高重复度工作流(定期报告、代码审查、数据清洗) 你运行敏感工作流,需要默认沙盒保护 你是开发者或研究者,需要技能的复利效应组合方案 两者并非对立,可以搭配使用:Hermes Agent 做指挥中心(记忆沉淀、技能生成、任务规划),OpenClaw 做执行端(利用多平台能力完成具体操作),实现自动成长 + 高效执行的能力互补。迁移指南 如果你已经在用 OpenClaw 想迁移到 Hermes Agent,好消息是 Hermes 内置了专用迁移工具: # 预览将迁移的内容 hermes claw migrate --dry-run# 执行迁移 hermes claw migrate迁移内容包括人格文件(SOUL.md)、记忆、技能、消息设置、API 密钥等。⚠️ 注意:OpenClaw 的 25+ 渠道中只有 7 个能迁移到 Hermes。如果依赖 iMessage、飞书、微信等独占渠道,建议两者并存。写在最后 2026 年的 AI Agent 赛道,OpenClaw 和 Hermes Agent 代表了两种截然不同的设计哲学:OpenClaw 相信「人是决策中心」——你定义规则,AI 执行 Hermes Agent 相信「AI 可以自己进化」——你给机会,AI 成长没有绝对的对错,只有是否匹配你的需求。但有一点是确定的:AI Agent 的未来,一定是这两条路线的融合——既要有 OpenClaw 的广度连接能力,也要有 Hermes 的深度进化能力。 现在,你想让 AI 做你的遥控器,还是做你的学徒?参考来源:Nous Research GitHub、OpenClaw 官方文档及社区对比分析
- Brody
- 2026/05/25
在 macOS 上用 oMLX 跑本地大模型:Apple Silicon 专属推理服务器完全指南
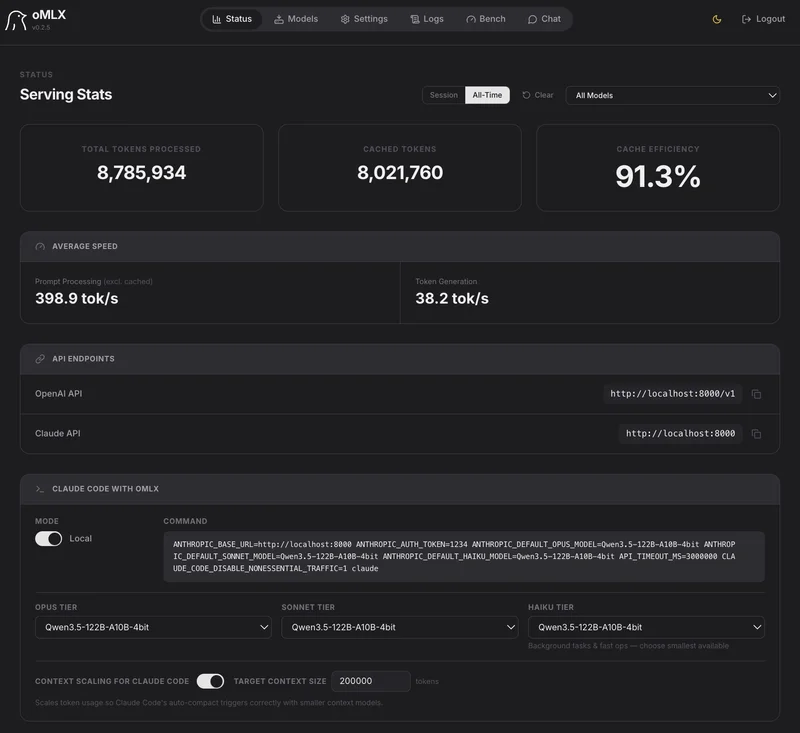
如果你在用 Apple Silicon 的 Mac(M1/M2/M3/M4),想跑本地大模型来辅助编程或写作,大概率试过 Ollama 或 LM Studio。它们能用,但都有同一个痛点:上下文一长,响应就慢得让人想放弃。 oMLX 就是为了解决这个问题而生的。oMLX 是什么? oMLX 是一款专为 Apple Silicon Mac 优化的本地 LLM 推理服务器,基于 Apple 官方的 MLX 框架构建。它的核心亮点是 智能 SSD KV 缓存——把推理过程中的 KV 缓存持久化到磁盘,让 Claude Code、Cursor、OpenClaw 等 AI 编程工具在长上下文场景下的响应时间从 30–90 秒缩短到 5 秒以内。✅ 开源协议:Apache 2.0 ✅ 运行平台:Apple Silicon + macOS 15+ ✅ GitHub:https://github.com/jundot/omlx(15k+ Stars)核心特性 1. 分页 SSD KV 缓存(最核心的差异化功能) 这是 oMLX 区别于 Ollama / LM Studio 的根本原因。 传统推理服务器的 KV 缓存在内存中,一旦上下文变化或服务器重启,缓存全部丢失,需要重新计算。oMLX 将所有 KV 缓存块以 safetensors 格式持久化到 SSD,并通过 LRU 策略在内存热层和磁盘冷层之间智能调度: 热层(RAM)←→ 冷层(SSD,safetensors 格式)实际效果:即使你切换了对话话题、或者重启了服务器,之前算过的上下文前缀不需要重新计算,TTFT(首 Token 响应时间)从 30–90 秒降至 5 秒以内。 2. 连续批处理(高吞吐) 通过 mlx-lm 的 BatchGenerator 处理并发请求,不再因单个请求阻塞整个队列。 实测数据(M3 Ultra 512GB,Qwen3.5-122B-A10B-4bit):并发数 Token/s 加速比1× 56.6 1.00×2× 92.1 1.63×4× 135.1 2.39×8× 190.2 3.36×Qwen3-Coder-Next-8bit 在 8× 并发下最高可达 4.14× 加速。 3. 原生 macOS 菜单栏应用oMLX 提供了一个非 Electron的原生 macOS 菜单栏应用(用 PyObjC 实现),可以从菜单栏直接启动/停止/监控服务器,无需开着终端窗口。 应用已签名并公证,支持应用内自动更新。 4. OpenAI + Anthropic 双协议兼容 这是 oMLX 对 AI 编程工作流最友好的地方:提供 /v1/chat/completions(OpenAI 兼容端点) 提供 /v1/messages(Anthropic 原生端点) 兼容 Claude Code、Cursor、OpenClaw 及所有 OpenAI 兼容客户端Web 仪表盘可以一键生成各工具的配置命令,直接复制粘贴即可使用。5. 多模型同时服务 可以同时加载 LLM、VLM(视觉语言模型)、Embedding、Reranker 多种模型。内存不足时自动按 LRU 策略淘汰,也可以手动固定常用模型始终保持加载。系统要求配置 最低要求 推荐配置芯片 Apple Silicon(M1 或更新) M 系列 Pro/Max系统 macOS 15.0+(Sequoia) macOS 15+内存 16GB RAM 64GB+存储 视模型大小而定(30GB+ 推荐) —安装方式 方式一:Homebrew(推荐,含 CLI) 如果你需要通过命令行启动服务,或者用 Claude Code 等工具集成,Homebrew 方式最方便: # 添加 tap brew tap jundot/omlx https://github.com/jundot/omlx# 安装 brew install omlx# 升级到最新版本 brew upgrade omlx安装完成后可以直接用 omlx 命令,也可以作为后台服务运行(崩溃自动重启): # 启动为后台服务 brew services start omlx# 查看服务状态 brew services info omlx# 停止服务 brew services stop omlx服务日志位置:服务管理日志:$(brew --prefix)/var/log/omlx.log 服务器运行日志:~/.omlx/logs/server.log💡 如果需要 MCP 工具支持,额外执行: /opt/homebrew/opt/omlx/libexec/bin/pip install mcp方式二:macOS App(最适合非技术用户)前往 GitHub Releases 下载 .dmg 文件 拖拽到 Applications 文件夹 启动后,欢迎界面会引导你完成:设置模型目录 → 启动服务器 → 下载第一个模型⚠️ 注意:macOS App 版本不包含 omlx CLI 命令。如果需要命令行控制,请选择 Homebrew 或源码安装方式。方式三:从源码安装(开发者) git clone https://github.com/jundot/omlx.git cd omlx# 仅安装核心功能 pip install -e .# 含 MCP 支持 pip install -e ".[mcp]"快速开始:启动你的第一个本地模型 第一步:准备模型目录 oMLX 需要从 HuggingFace 下载 MLX 格式的模型。你可以:直接用 oMLX 内置的模型下载器(推荐) 手动下载后放到指定目录 直接复用 LM Studio 的模型目录(无需重新下载)模型目录结构示例: ~/models/ ├── Qwen3.5-122B-A10B-4bit/ ├── Qwen3-Coder-Next-8bit/ ├── Step-3.5-Flash-8bit/ └── bge-m3/ ← Embedding 模型第二步:启动服务 Homebrew / 源码安装方式: omlx serve --model-dir ~/models启动后:API 端点:http://localhost:8000/v1 管理仪表盘:http://localhost:8000/admin 内置聊天界面:http://localhost:8000/admin/chatmacOS App 方式: 直接从 Applications 启动 oMLX,菜单栏会出现图标,点击即可管理服务器状态。 第三步:下载模型 打开管理仪表盘(/admin),在模型下载器里搜索并下载你需要的模型:仪表盘支持搜索 HuggingFace 上的 MLX 模型,查看模型卡片和文件大小,一键下载。与 Claude Code / Cursor 集成 这是 oMLX 最有价值的使用场景。配置完成后,你的 Claude Code 或 Cursor 就可以直接调用本地模型,所有数据都在本地运行,完全不依赖外网。 一键生成配置打开 oMLX 管理仪表盘 选择你要使用的模型 点击「一键生成配置命令」 复制命令,粘贴到终端执行oMLX 支持一键配置以下工具:工具 说明OpenClaw 一键生成配置OpenCode 一键生成配置Codex 一键生成配置Hermes Agent 一键生成配置GitHub Copilot 一键生成配置Pi 一键生成配置手动配置示例 如果你需要手动配置,只需要将 API 端点指向本地: # OpenAI 兼容客户端 export OPENAI_API_BASE="http://localhost:8000/v1" export OPENAI_API_KEY="dummy" # oMLX 默认不需要 key# Anthropic 兼容客户端(Claude Code) export ANTHROPIC_API_KEY="dummy" export ANTHROPIC_BASE_URL="http://localhost:8000"支持的模型 oMLX 支持所有来自 HuggingFace 的 MLX 格式模型,包括:模型系列 说明Qwen 含 Qwen3.5 MoE、Qwen3-Coder,推荐日常使用LLaMA Meta 系列Mistral Mistral AI 系列Gemma Google 系列DeepSeek 自动处理 <think> 标签GLM 智谱系列MiniMax 自动处理 <think> 标签VLM 视觉语言模型(v0.2.0+ 支持,含 SSD 缓存)Embedding / Reranker 可同时加载,用于 RAG 场景💡 模型选择建议:如果你主要用本地模型辅助编程,优先选择 Qwen3-Coder 或 Qwen3.5 系列,工具调用支持最好,速度也最快。管理仪表盘详解 oMLX 的管理仪表盘(/admin)是一个功能完整的 Web UI,所有 CDN 依赖均已本地化,完全离线可用。主要功能:实时监控:Token/s、并发数、内存占用等实时指标 模型管理:加载/卸载模型、设置每模型参数、固定常用模型 内置聊天:支持对话历史、模型切换、深色模式、VLM 图像上传 基准测试:一键测试预填充和生成速度 配置生成器:为各工具生成配置命令 多语言支持:英语、中文、日语、韩语、法语、俄语进阶配置 启用 SSD KV 缓存 omlx serve \ --model-dir ~/models \ --paged-ssd-cache-dir ~/.omlx/cache \ --hot-cache-max-size 20%--paged-ssd-cache-dir:指定 SSD 缓存目录 --hot-cache-max-size:热缓存占系统 RAM 的最大比例限制内存使用 # 限制单个模型最大内存 omlx serve --model-dir ~/models --max-model-memory 32GB# 限制进程总内存(默认:系统 RAM - 8GB) omlx serve --model-dir ~/models --max-process-memory 80%调整并发数 # 最大并发请求数(默认 8) omlx serve --model-dir ~/models --max-concurrent-requests 16启用 MCP 工具 omlx serve --model-dir ~/models --mcp-config ~/mcp.jsonAPI 密钥认证 omlx serve --model-dir ~/models --api-key your-secret-keyoMLX vs Ollama vs LM Studio对比项 Ollama LM Studio oMLXKV 缓存存储 仅内存 仅内存 内存 + SSD 持久化缓存失效后 全量重新计算 全量重新计算 从 SSD 毫秒级恢复TTFT(长上下文) 30–90 秒 30–90 秒 < 5 秒并发处理 单请求队列 单请求队列 连续批处理Anthropic 端点 不支持 不支持 原生支持菜单栏管理 无 有 有(原生非 Electron)适合场景 简单推理 图形化交互 AI 编程工作流架构概览 如果你对技术架构感兴趣,oMLX 的核心设计如下: FastAPI Server (OpenAI / Anthropic API) │ ├── EnginePool(多模型、LRU 驱逐、TTL) │ ├── BatchedEngine(LLM,持续批处理) │ ├── VLMEngine(视觉语言模型) │ ├── EmbeddingEngine │ └── RerankerEngine │ └── Cache Stack ├── PagedCacheManager(GPU,基于块,CoW,前缀共享) ├── Hot Cache(内存热层) └── PagedSSDCacheManager(SSD 冷层)这套架构的核心思路是:把 KV 缓存当作操作系统的虚拟内存来管理——热块在 RAM,冷块在 SSD,按需换入换出,服务器重启后缓存不丢失。总结 如果你在用 Mac 做 AI 辅助编程,oMLX 是目前最值得尝试的本地模型方案。它的 SSD KV 缓存设计真正解决了长上下文场景下的实用性问题,而原生菜单栏应用和一键工具集成也让日常使用变得非常顺手。 最重要的是:数据完全本地,不需要联网,不需要 API Key,不需要担心隐私泄露。 获取方式:官网:https://omlx.ai GitHub:https://github.com/jundot/omlx Homebrew 一键安装:brew tap jundot/omlx && brew install omlx参考资料:oMLX 官方文档(https://omlx.ai)及 GitHub 仓库(https://github.com/jundot/omlx)
- Brody
- 2026/05/25
算法时代的生存指南:重读《你的降落伞是什么颜色》,寻找不被 AI 替代的底气
引言:2026 年的职场失语症 现在是 2026 年。 不管你承不承认,我们都患上了「AI 失语症」。 早上醒来,GPT-X 已经写好了你要的策划案,Midjourney 生成的图比设计总监还快,Sora 生成的视频让剪辑师感到窒息。曾经我们引以为傲的「硬技能」——无论是写代码、翻译、还是数据分析,在飞速迭代的大模型面前,似乎都变得不堪一击。 身边不断有人换赛道,有人「毕业」,更多的人在问同一个问题:「如果 AI 能做我现在 90% 的工作,那我存在的意义是什么?」 最近,我在整理旧书架时,翻出了一本「古董书」——理查德·尼尔森·波尔斯的《你的降落伞是什么颜色?》(What Color Is Your Parachute?)。 这本书初版于 1970 年。你可能会笑:「在这个满大街都是机器人的年代,一本半个世纪前的书还能教我怎么找工作?」 但我重读之后,惊出了一身冷汗。原来,它从来不是一本教你「怎么写简历」的书,而是一本教你「如何在动荡世界里定义自己」的生存手册。 在 2026 年的当下,这本书里的这三个观点,或许比任何 AI 工具书都更值得我们深读。第一点:从「名词」回归「动词」——哪怕赛道消失,你的能力永存 书中观点:可迁移技能(Transferable Skills)是职场的硬通货。 在 2026 年,我们最大的恐惧是「职位消失」。比如你是「翻译」,当翻译软件实时同传普及了,这个职位就没了。 但《降落伞》早就告诉我们:不要用「职位头衔(名词)」来定义自己,要用「技能(动词)」。你不是一个「文案编辑」(名词,容易被 AI 替代); 你是一个「擅长用文字共情、能从复杂信息中提炼观点并说服他人的人」(动词,AI 很难完美做到)。AI 时代的启示 AI 擅长处理数据和逻辑,但它不懂「人味儿」。书里提到的「与人打交道的技能」、「综合与创造的技能」,在 2026 年反而成了奢侈品。 请重新盘点你的技能包:沟通、共情、甚至「在混乱中做决策」的能力。这些被称为「可迁移技能」,它们是你换赛道时的底气。赛道会死,但技能会随你迁徙。第二点:不要试图骗过算法,去连接「具体的人」 书中观点:求职的「数字游戏」效率极低,建立人际桥梁(The Bridge)才是王道。 2026 年的招聘有多绝望?HR 很少看简历了,第一轮筛选全交给了 AI。你的简历因为少写了几个关键词,直接被系统扔进了垃圾桶。 几十年前,波尔斯就痛斥过这种「撒网式」求职。他提出了「信息面试」(Informational Interviewing)的概念。 AI 时代的启示 当所有人都在用 AI 生成完美的简历去轰炸招聘网站时,「面对面」变得无比珍贵。 不要只盯着招聘启事(那是红海),去寻找你感兴趣的公司里的人。约他们喝杯咖啡(或者是线上的 VR 会议),不是去求职,而是去请教:「现在的行业变化这么快,您觉得核心挑战是什么?」 「如果我想进入这个领域,您建议我补足哪块短板?」在算法统治的世界里,只有「人」才能绕过算法,把机会给另一个「人」。回归线下的真实链接,是 2026 年最高级的求职黑客技术。第三点:那朵著名的「花」——在这个时代,你是谁比你会什么更重要 书中观点:花瓣练习(The Flower Exercise),全方位解构理想生活。 这是全书最经典的工具。作者让你画一朵花,填入你最喜欢的环境、最想服务的人群、最想发挥的特长、最重视的价值观等。 以前读这章,觉得太虚,只想搞钱。但到了 2026 年,当 AI 把枯燥的执行工作接管后,我们终于有时间面对那个终极问题:「我想过什么样的生活?」 AI 时代的启示 AI 没有价值观,没有偏好,它没有灵魂。 如果你不知道自己是谁,你就会成为 AI 的附庸。 现在的我们,更需要做一次彻底的「花瓣练习」。如果你讨厌现在的行业,不是因为你不行,可能是因为这个「环境」不适合你的「花瓣」。 你要找的不是一份「工作」,而是一个能让你这朵花盛开的「生态系统」。在 2026 年,只有个性鲜明、知道自己要什么的人,才不会被标准化的 AI 淹没。结语 2026 年,技术在狂飙,但人性的底层逻辑从未改变。 《你的降落伞是什么颜色》告诉我们:这世界上没有一份工作是「铁饭碗」,唯一的铁饭碗,是你对自己能力的认知,和对未来的掌控感。 当你在高空坠落,感到迷茫恐慌时,别指望 AI 能接住你。你需要打开那顶属于你自己的降落伞。 只要你知道自己是谁,要去向何方,你就永远不会被时代抛弃。